
Исследовательская группа Frontier Red Team Anthropic опубликовала результаты серии экспериментов с многоагентными системами. Ученые пришли к выводу, что с увеличением автономности ИИ-агентов их взаимодействие может приносить не только новые возможности, но и создавать системные риски. Среди них-проблемы с координацией, заговор, чрезмерное доверие к полученной информации и эскалация конфликтов.
По оценке Anthropic, современные агенты уже могут выполнять все больше и больше задач в общих репозиториях кода, на финансовых рынках и в других социальных системах. В то же время большинство имеющихся институтов создавались для людей и предусматривают контроль с человеческой скоростью. В будущем часть таких систем может стать гибридной, объединяя людей и ИИ, а там, где агенты окажутся быстрее или дешевле, – полностью автоматизированной. Исследователи предупреждают, что количество взаимодействий между ИИ может превысить количество контактов между людьми и между людьми и ИИ еще до появления надежных правил для таких систем.
Авторы подчеркивают, что агенты существенно отличаются от людей. Они могут работать в течение длительного времени, быстро анализировать огромные объемы информации и обладают широкими знаниями. Однако модели склонны к конфабуляциям – созданию правдоподобной, но неверной информации-и к «взлому» целевой функции, когда попытка достичь определенной метрики приводит к нежелательным последствиям. Отдельные особенности поведения при масштабировании могут в итоге превращаться в системные проблемы.
Координация при поиске уязвимостей
Согласно Anthropic, современные агенты хорошо воспринимают другие системы как инструменты с четкими входными и выходными данными. Значительно сложнее им работать с другими агентами как с самостоятельными участниками, которые имеют собственные цели и могут действовать в течение длительного времени без очевидной иерархии. Это особенно важно в ситуациях, когда агенты должны не просто выполнять задачи параллельно, а зависеть от результатов работы друг друга.
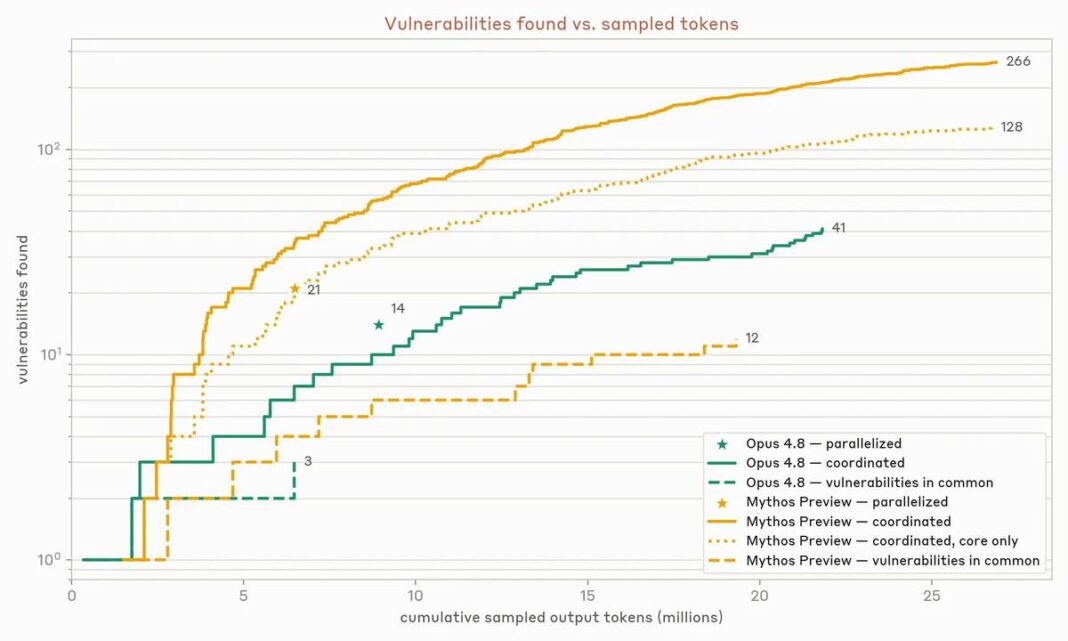
В одном из экспериментов исследователи сравнили два способа поиска уязвимостей в 15 проектах с открытым исходным кодом. В первом случае независимые агенты получали отдельные участки кода для проверки. Во втором 45 агентов работали на своих виртуальных машинах, имели общий форум для координации и получали ту же задачу. Они проверяли находки друг друга, а отдельный агент-арбитр определял, была ли уязвимость новой и подлинной.
Координированная группа на модели Claude Mythos Preview нашла 266 уязвимостей, использовав 27 млн токенов. Независимые агенты обнаружили 21 уязвимость за 6,5 млн токенов. В то же время примерно половина находок координированной группы касалась каталогов за пределами основного кода, который проверяли независимые агенты. Если ограничить поиск одними и теми же основными каталогами, эффективность двух подходов в расчете на одну обнаруженную уязвимость была примерно одинаковой.
В то же время результаты двух подходов почти не пересекались: совпали лишь 12 уязвимостей. В Anthropic объясняют это тем, что координированная группа самостоятельно определяла перспективные направления, создавала вспомогательные инструменты и специализировалась на различных типах ошибок. Независимые агенты, напротив, заранее получали конкретные области для поиска. Авторы предполагают, что в будущем специализация и координация могут оказаться более эффективными, чем простое масштабирование количества параллельных агентов.
Проблемы совместной разработки
Чтобы проверить более сложную форму сотрудничества, исследователи поручили группам агентов создать текстовую фэнтезийную игру с открытым миром, доступную через браузер. Каждый агент работал на своей виртуальной машине, но имел доступ к общему форуму и отдельному репозиторию. Группы различались по количеству агентов и используемым моделям, и каждая симуляция длилась 12 часов.
Помимо базовой инструкции работать в командах и сотрудничать, исследователи протестировали два дополнительных сценария: с готовыми ролями для программирования, проектирования и тестирования и с иерархической структурой, где один агент выполнял роль «генерального директора» и распределял задачи. Существенной разницы между этими подходами не обнаружили. Все созданные игры были низкого качества: работали медленно, имели непонятный интерфейс и требовали слишком много времени для освоения. Авторы отмечают, что моделям пока не хватает ощущения качества продукта, поэтому они все еще нуждаются в значительном человеческом контроле.
Чтобы оценить координацию, команда проанализировала долю pull request (PR), которая попала в основную ветку, а также уровень совместного использования кода. Ранние модели Sonnet 4. 6 и Opus 4. 6 плохо согласовывали работу: агенты редактировали одни и те же файлы, из-за чего PR часто конфликтовали и не объединялись. В симуляциях с 80 агентами Sonnet 4. 6 и Opus 4. 6 создали 876 и 980 PR соответственно, но только небольшая часть из них была принята.
Новые модели Opus 4. 8 и Mythos Preview смогли избежать значительного количества конфликтов в основном из-за изоляции. Агенты почти полн